El corpus COLA corresponde al Corpus Oral de Lenguaje Adolescente. Esta página conserva la entrada histórica en español y reúne enlaces a transcripciones, publicaciones y documentos relacionados con el proyecto.
Qué es el corpus oral de lenguaje adolescente
El proyecto se desarrolló en la Universidad de Bergen como continuación del Bergen Corpus of London Teenage Language, conocido por su sigla COLT, que había documentado el habla de los adolescentes londinenses. La idea era construir para el español lo que ya existía para el inglés, y construirlo con el mismo procedimiento, porque solo así los dos conjuntos de datos resultan comparables entre sí.
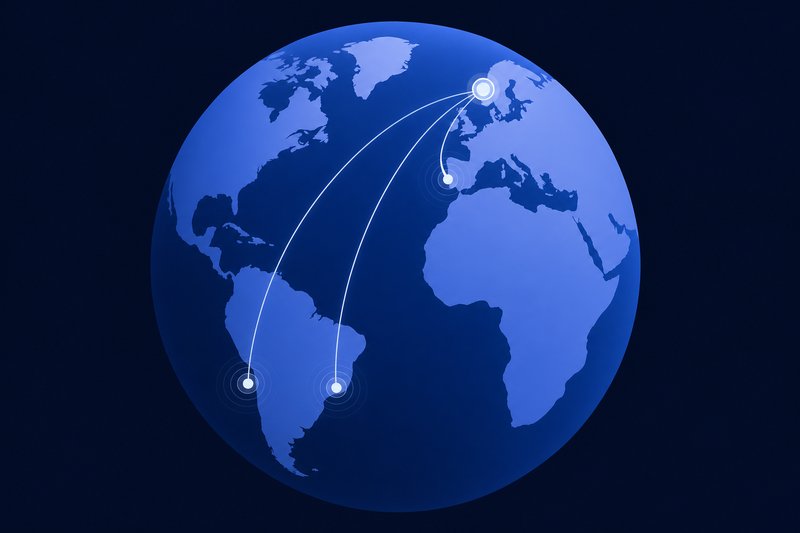
El diseño siguió el método del British National Corpus descrito por Crowdy en 1991. Las grabaciones recogen conversaciones espontáneas entre jóvenes de entre trece y diecinueve años en contextos informales, registradas por ellos mismos con minidiscos y sin presencia adulta. El material se reunió en tres subcorpus según la ciudad: COLAm en Madrid, COLAb en Buenos Aires y COLAs en Santiago de Chile. Los participantes se clasificaron además según criterios sociológicos de estrato, lo que permite separar una diferencia entre ciudades de una diferencia entre grupos sociales.
Qué permite estudiar el corpus COLA
El corpus oral de lenguaje adolescente resultante permite abordar fenómenos que la lengua escrita no registra: la alternancia de código, las estrategias de cortesía, el uso de vocativos, las muletillas de cada generación y la influencia del inglés en el habla juvenil. Cada grabación se transcribió con convenciones que anotan turnos, pausas y solapamientos, de modo que un fragmento puede citarse y verificarse sin volver al audio.
Los objetivos declarados del proyecto iban en varias direcciones a la vez: describir los rasgos estructurales y pragmáticos del habla juvenil, medir la influencia del inglés sobre el español de los jóvenes, observar diferencias entre el habla de chicas y chicos, estudiar el cambio de código según el interlocutor y registrar las diferencias sociolectales. La comparación con material inglés y noruego recogido de la misma forma es lo que convierte esa descripción en un estudio contrastivo.
Difusión y colaboración académica
El proyecto se presentó en congresos internacionales durante sus primeros años, entre ellos las reuniones de ICAME celebradas en Gotemburgo en 2002 y en Guernsey en 2003, el encuentro de EDICE en Estocolmo en 2002, un congreso sobre análisis del discurso en la Universidad de Navarra en noviembre de 2002 y un simposio sobre marcadores pragmáticos en Bruselas en mayo de 2003.
El material atrajo después a investigadores de otras universidades, que pasaron estancias en Bergen para trabajar con él: procedían, entre otras, de la Universidad Pablo de Olavide de Sevilla, la Universidad de Santiago de Compostela, la Universidad Pompeu Fabra, la Universidad de Navarra y la Universidad Complutense de Madrid. Uno de esos trabajos aplicó el material al estudio del parlache de Medellín, una variedad que el corpus no documenta pero con la que sí admite comparación.
Comunicaciones y artículos sobre el corpus
El corpus también se dio a conocer fuera de la investigación. En el II Congreso nacional de ANPE, dedicado a la multiculturalidad y la norma policéntrica en el aula de español como lengua extranjera y celebrado los días 26 y 27 de septiembre de 2008, Eli-Marie Danbolt Drange, de la Universidad de Bergen, leyó la comunicación «Un corpus oral en línea como recurso didáctico». Parte de la pregunta de qué es un corpus, sitúa COLA junto a los dos corpus de la Real Academia Española, el Corpus de Referencia del Español Actual (CREA) y el Corpus diacrónico del español (CORDE), y muestra cómo las transcripciones permiten oír y leer a la vez a jóvenes hispanohablantes en una clase que aprende la lengua lejos de su contexto.
- «Un corpus oral en línea como recurso didáctico» (2008), Eli-Marie Danbolt Drange, comunicación en el II Congreso nacional de ANPE: Multiculturalidad y norma policéntrica: aplicaciones en el aula de ELE
- «COLA, Un Corpus Oral de Lenguaje Adolescente» (2008), en Anejos a Oralia
- «La lengua juvenil de las metrópolis Madrid y Santiago de Chile» (2011), con Eli-Marie Drange, en Arena Romanística 9
El artículo de Anejos a Oralia presenta el corpus en su conjunto. El de Arena Romanística se ciñe a dos de sus tres ciudades y compara el habla juvenil de Madrid con la de Santiago de Chile.
Preguntas frecuentes
¿Qué quiere decir la sigla COLA?
Corpus Oral de Lenguaje Adolescente. La sigla se eligió en paralelo a COLT, el corpus de habla adolescente londinense reunido antes en la misma universidad, del que el proyecto español es continuación.
¿Qué ciudades documenta el material?
Tres, cada una con su subcorpus: Madrid en COLAm, Buenos Aires en COLAb y Santiago de Chile en COLAs. La combinación de una variedad peninsular con dos americanas es lo que permite contrastar un mismo fenómeno entre ellas.
¿Por qué grabaron los propios jóvenes las conversaciones?
Porque la presencia de un investigador cambia lo que se dice y cómo se dice. Entregar el aparato a los participantes y retirarse es el procedimiento que heredaron del British National Corpus y de COLT, y es lo que hace que el material documente habla espontánea.
¿Es un corpus de español de España?
No solo. Dos de los tres subcorpus son americanos, y buena parte de las publicaciones asociadas comparan precisamente Madrid con Santiago de Chile o con Buenos Aires, por ejemplo en el uso de vocativos y de las formas de tratamiento.